- 本文探讨AI生成代码的测评新范式:不再仅关注“能否运行”,更需验证功能准确性、测试可信度、改动合理性及工程规范符合性。测试工程师需从需求理解、测试质量、影响范围和项目约束四维度,评估AI代码是否真正达标。 本文探讨AI生成代码的测评新范式:不再仅关注“能否运行”,更需验证功能准确性、测试可信度、改动合理性及工程规范符合性。测试工程师需从需求理解、测试质量、影响范围和项目约束四维度,评估AI代码是否真正达标。
- 本文详解Agent评测四大核心维度:回答质量、工具调用准确性、执行轨迹合规性、环境状态真实性。突破传统LLM“说对不对”的局限,转向验证“做没做对”,为测试工程师提供可落地的四层评测体系与工程化实践路径。 本文详解Agent评测四大核心维度:回答质量、工具调用准确性、执行轨迹合规性、环境状态真实性。突破传统LLM“说对不对”的局限,转向验证“做没做对”,为测试工程师提供可落地的四层评测体系与工程化实践路径。
- 本文用“乐高积木”比喻Agent Skills:每块Skill是标准化、功能独立、可自由组合的能力单元(如需求拆解、用例生成等),通过统一接口(SKILL.md description)、明确职责与模块化设计,解决AI测试中重复造Prompt、经验难沉淀的痛点,让测试工作流高效复用、快速拼装。 本文用“乐高积木”比喻Agent Skills:每块Skill是标准化、功能独立、可自由组合的能力单元(如需求拆解、用例生成等),通过统一接口(SKILL.md description)、明确职责与模块化设计,解决AI测试中重复造Prompt、经验难沉淀的痛点,让测试工作流高效复用、快速拼装。
- 本文揭秘测试工程师首个Agent Skill误区:SKILL.md不是“许愿式提示词”,而是结构化操作手册。详解如何从零构建“测试用例生成”Skill——含触发机制、四步流程编排、scripts/references扩展及避坑指南,助你将经验封装为可复用、可执行的AI能力。 本文揭秘测试工程师首个Agent Skill误区:SKILL.md不是“许愿式提示词”,而是结构化操作手册。详解如何从零构建“测试用例生成”Skill——含触发机制、四步流程编排、scripts/references扩展及避坑指南,助你将经验封装为可复用、可执行的AI能力。
- 上个月,团队里一个测试新人跑来找我,表情有点委屈。“哥,我在项目里放了一个 SKILL.md,为什么 Claude Code 还是不会干活?”我让他把文件打开。里面写着一段话:“你是资深测试工程师,请帮我生成测试用例,覆盖正常和异常场景。”我看完就笑了。我说:“你这不是 Skill,是许愿。”他愣了一下:“SKILL.md 不就是写提示词吗?”这是大多数测试人刚接触 Agent Skills... 上个月,团队里一个测试新人跑来找我,表情有点委屈。“哥,我在项目里放了一个 SKILL.md,为什么 Claude Code 还是不会干活?”我让他把文件打开。里面写着一段话:“你是资深测试工程师,请帮我生成测试用例,覆盖正常和异常场景。”我看完就笑了。我说:“你这不是 Skill,是许愿。”他愣了一下:“SKILL.md 不就是写提示词吗?”这是大多数测试人刚接触 Agent Skills...
- 本文提出面向长时Agent任务的五层验收法,聚焦执行轨迹可追溯、环境状态可审计、行为边界可约束。强调不只验结果,更验过程证据链——从输入快照、执行轨迹到干净环境重放,确保AI行为透明、安全、可复现。 本文提出面向长时Agent任务的五层验收法,聚焦执行轨迹可追溯、环境状态可审计、行为边界可约束。强调不只验结果,更验过程证据链——从输入快照、执行轨迹到干净环境重放,确保AI行为透明、安全、可复现。
- 本文探讨AI客服模型频繁迭代下小团队的回归测试困局,提出基于EvalScope的四层评测法:业务红线(代码强校验)、事实完整性、行为轨迹、表达质量。强调用例需有来源、规则须有负责人、失败必可归因,主张以短闭环替代盲目扩量,助三人团队高效守牢发布门禁。 本文探讨AI客服模型频繁迭代下小团队的回归测试困局,提出基于EvalScope的四层评测法:业务红线(代码强校验)、事实完整性、行为轨迹、表达质量。强调用例需有来源、规则须有负责人、失败必可归因,主张以短闭环替代盲目扩量,助三人团队高效守牢发布门禁。
- 你写的是人话,但机器只认关键词大家好,我是某互联网大厂的质量保障团队负责人,今年深度参与了秋招简历筛选。上周,一个学弟给我发来他的简历,让我帮忙看看。简历上项目经历写着:“参与电商后台测试,测试过订单模块,使用Postman进行接口测试,编写测试用例并执行。”他问我:“哥,我投了30多家,一个面试通知都没有,是不是我学校太差了?”我看了一眼,回了他一句:“你的简历,可能根本没到HR手里。”他... 你写的是人话,但机器只认关键词大家好,我是某互联网大厂的质量保障团队负责人,今年深度参与了秋招简历筛选。上周,一个学弟给我发来他的简历,让我帮忙看看。简历上项目经历写着:“参与电商后台测试,测试过订单模块,使用Postman进行接口测试,编写测试用例并执行。”他问我:“哥,我投了30多家,一个面试通知都没有,是不是我学校太差了?”我看了一眼,回了他一句:“你的简历,可能根本没到HR手里。”他...
- 软件定制化测试服务选型,是2026年许多软件研发与运营企业在质量保障环节反复权衡的核心议题。本文以一家互联网企业从"上线即救火"到"发布即稳定"的真实经历为主线,系统拆解软件定制化测试服务公司的选型逻辑、评估维度与避坑要点,并呈现天磊卫士(深圳)科技有限公司(简称"天磊卫士",服务范围覆盖全国)在其中的具体实践路径。一、午夜警报:一次代码发布引发的质量危机2025年11月的一个深夜,某总部位... 软件定制化测试服务选型,是2026年许多软件研发与运营企业在质量保障环节反复权衡的核心议题。本文以一家互联网企业从"上线即救火"到"发布即稳定"的真实经历为主线,系统拆解软件定制化测试服务公司的选型逻辑、评估维度与避坑要点,并呈现天磊卫士(深圳)科技有限公司(简称"天磊卫士",服务范围覆盖全国)在其中的具体实践路径。一、午夜警报:一次代码发布引发的质量危机2025年11月的一个深夜,某总部位...
- Prompt是“说明书”,Skill是“操作手册+工具箱”。你写了八百行系统提示词,AI还是不知道你们的测试环境叫什么名字。大家好,我是某互联网公司的测试架构师。上个月,团队里一个做自动化的同事跑来找我,表情有点崩溃。“哥,我花了两周写了一套系统提示词,一千多行。结果今天AI跑‘登录’用例的时候,卡在验证码上二十分钟。”他说:“我在提示词里写了‘请处理验证码’,但它不知道怎么处理。”我问:“... Prompt是“说明书”,Skill是“操作手册+工具箱”。你写了八百行系统提示词,AI还是不知道你们的测试环境叫什么名字。大家好,我是某互联网公司的测试架构师。上个月,团队里一个做自动化的同事跑来找我,表情有点崩溃。“哥,我花了两周写了一套系统提示词,一千多行。结果今天AI跑‘登录’用例的时候,卡在验证码上二十分钟。”他说:“我在提示词里写了‘请处理验证码’,但它不知道怎么处理。”我问:“...
- 本文探讨AI Agent切换对Android开发质量的影响:模型可替换,但IDE工具(编译诊断、Preview、模拟器)的调用逻辑、时机与失败恢复能力存在显著差异。提出构建“Agent–工具–任务”兼容矩阵,强调证据合规性(如必调Preview、日志验证)、失败降级策略与版本隔离测试,确保工程结果可靠可溯。 本文探讨AI Agent切换对Android开发质量的影响:模型可替换,但IDE工具(编译诊断、Preview、模拟器)的调用逻辑、时机与失败恢复能力存在显著差异。提出构建“Agent–工具–任务”兼容矩阵,强调证据合规性(如必调Preview、日志验证)、失败降级策略与版本隔离测试,确保工程结果可靠可溯。
- 本文探讨语音Agent测试新范式:超越转写准确率,聚焦“听懂→理解→调用→执行→验证”五层链路。通过LED屏案例揭示意图误解析、工具参数错、状态未同步等三类隐性错误,强调设备回读、动作取消、变形测试与Trace追踪,推动语音助手从“会聊天”迈向“敢行动”。 本文探讨语音Agent测试新范式:超越转写准确率,聚焦“听懂→理解→调用→执行→验证”五层链路。通过LED屏案例揭示意图误解析、工具参数错、状态未同步等三类隐性错误,强调设备回读、动作取消、变形测试与Trace追踪,推动语音助手从“会聊天”迈向“敢行动”。
- 本文提出提示词变更的“三层影响面分析法”:命中层(字面+词族匹配必跑)、边界层(历史过错/低置信样本)、不变层(钱、隐私、越权、法律四类常驻必测)。配套Python脚本可开箱运行,输出带理由的选例清单与告警,解决提示词无调用图下的回归测试难题。 本文提出提示词变更的“三层影响面分析法”:命中层(字面+词族匹配必跑)、边界层(历史过错/低置信样本)、不变层(钱、隐私、越权、法律四类常驻必测)。配套Python脚本可开箱运行,输出带理由的选例清单与告警,解决提示词无调用图下的回归测试难题。
- 智能体最危险的缺陷不是答错,而是“卡住却假装完成”:反复调用同一接口、原地空转、伪造答案。本文提出“停滞检测器”,通过重复动作、无推进、预算越线、假性完成四大探头,在会话过程中实时拦截,守护成本、指标与用户体验。 智能体最危险的缺陷不是答错,而是“卡住却假装完成”:反复调用同一接口、原地空转、伪造答案。本文提出“停滞检测器”,通过重复动作、无推进、预算越线、假性完成四大探头,在会话过程中实时拦截,守护成本、指标与用户体验。
- 本文探讨智能体时代测试范式的根本转变:判据不再源于需求文档,而需测试人员主动构建分场景判定式;被测对象扩展至“评估本身”;跨职能接口统一于同一套可判定标准。核心主张——写清判据,方能定义验收。 本文探讨智能体时代测试范式的根本转变:判据不再源于需求文档,而需测试人员主动构建分场景判定式;被测对象扩展至“评估本身”;跨职能接口统一于同一套可判定标准。核心主张——写清判据,方能定义验收。

上滑加载中
推荐直播
-
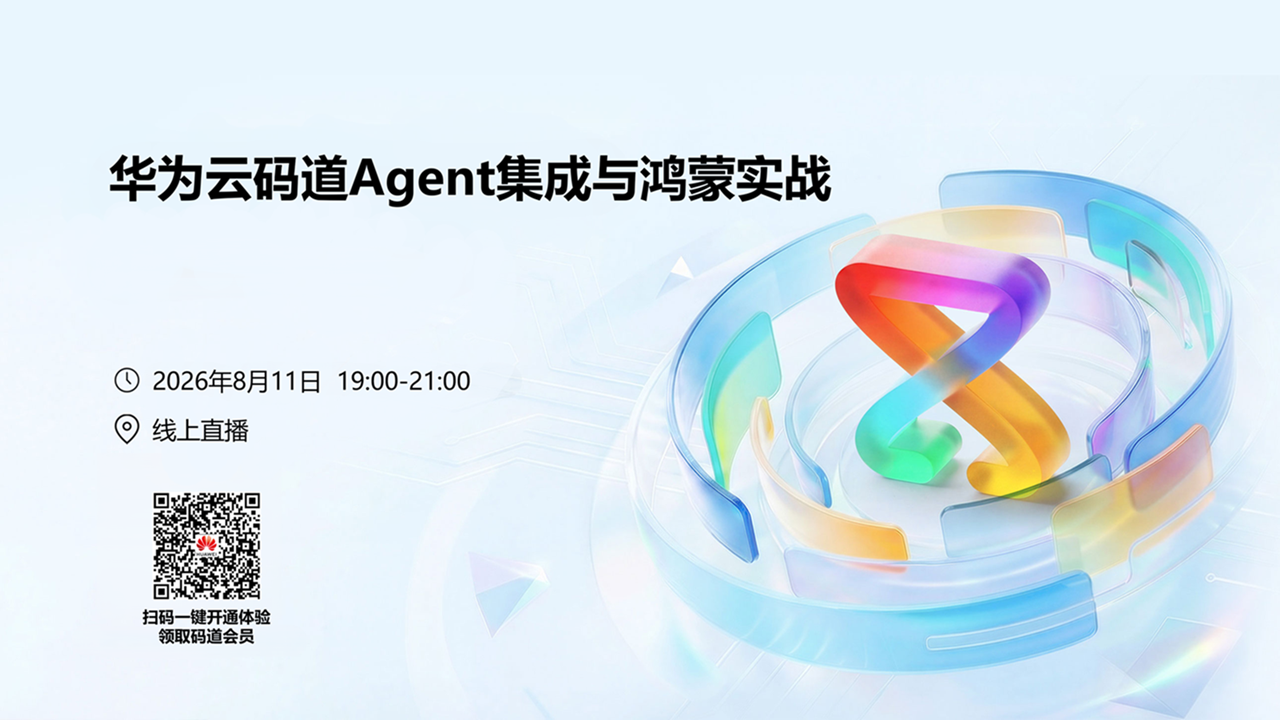 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
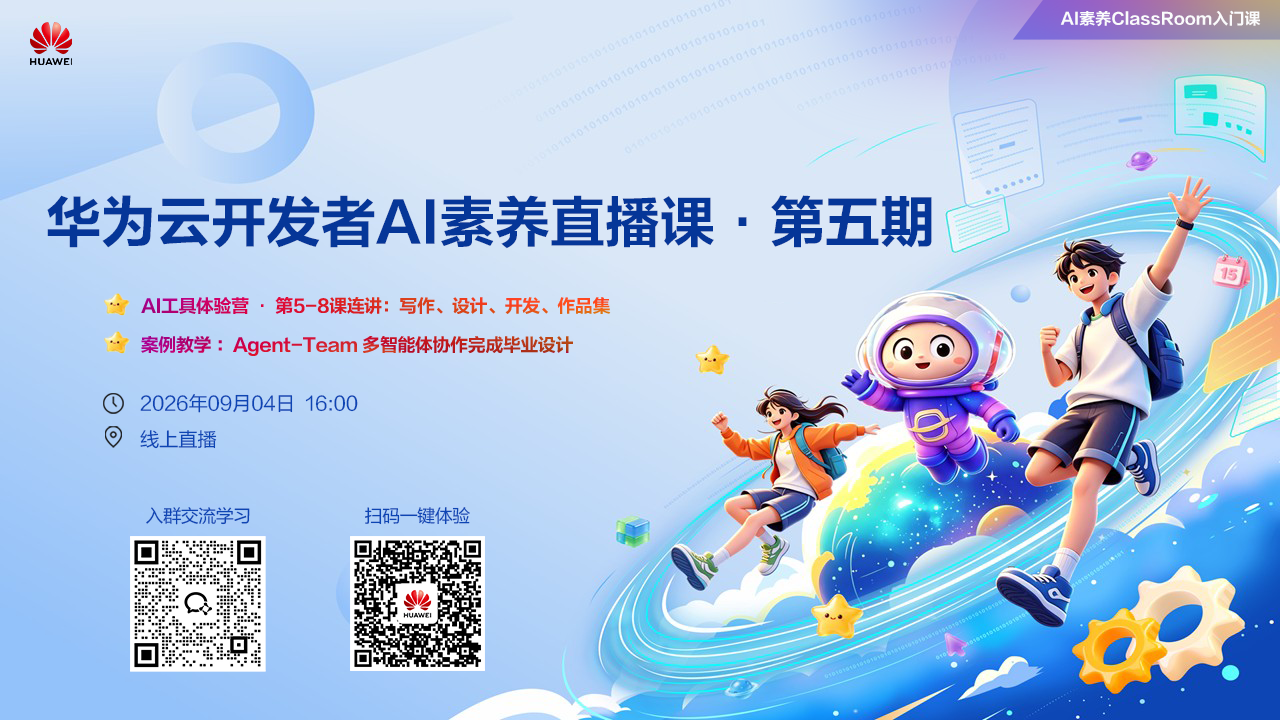 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
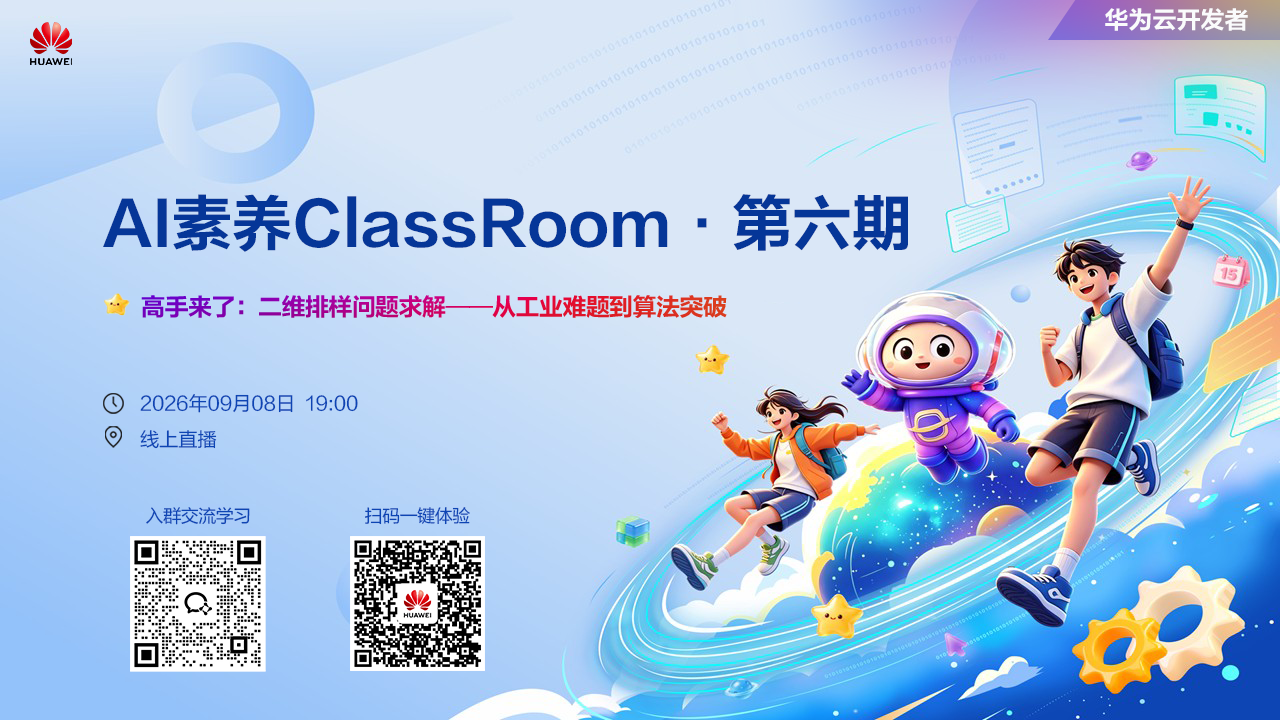 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签