- 自然语言处理(NLP)与地理信息系统(GIS)的融合正开启全新应用大门,带来智能地理信息检索、地理知识图谱构建、灾害预警优化及智能导航等创新。通过NLP理解复杂语义并转化为GIS指令,降低了用户门槛,提升了效率。然而,数据异构性、语义理解复杂性、计算资源瓶颈及复合型人才短缺等问题仍待解决。尽管面临挑战,未来NLP与GIS的深度融合将为各行业带来更多变革与发展机遇。 自然语言处理(NLP)与地理信息系统(GIS)的融合正开启全新应用大门,带来智能地理信息检索、地理知识图谱构建、灾害预警优化及智能导航等创新。通过NLP理解复杂语义并转化为GIS指令,降低了用户门槛,提升了效率。然而,数据异构性、语义理解复杂性、计算资源瓶颈及复合型人才短缺等问题仍待解决。尽管面临挑战,未来NLP与GIS的深度融合将为各行业带来更多变革与发展机遇。
- 自然语言处理(NLP)作为人工智能的璀璨明珠,已广泛应用于智能语音助手、机器翻译和内容创作等场景,极大提高了信息处理效率和跨语言交流。然而,公众对其原理和局限性了解有限,存在困惑与担忧。需通过科普宣传,引导公众正确认识NLP的优势与风险,关注数据隐私,避免虚假信息传播,消除误解,促进技术健康发展,造福社会。 自然语言处理(NLP)作为人工智能的璀璨明珠,已广泛应用于智能语音助手、机器翻译和内容创作等场景,极大提高了信息处理效率和跨语言交流。然而,公众对其原理和局限性了解有限,存在困惑与担忧。需通过科普宣传,引导公众正确认识NLP的优势与风险,关注数据隐私,避免虚假信息传播,消除误解,促进技术健康发展,造福社会。
- 在自然语言处理(NLP)领域,NLTK和SpaCy是Python中两大利器。NLTK功能全面、语料库丰富,适合学术研究与教学;SpaCy则以高效、准确和易用性著称,专为工业级应用设计。两者各有所长,可根据需求选择或结合使用,助力开发者实现强大的NLP功能。 在自然语言处理(NLP)领域,NLTK和SpaCy是Python中两大利器。NLTK功能全面、语料库丰富,适合学术研究与教学;SpaCy则以高效、准确和易用性著称,专为工业级应用设计。两者各有所长,可根据需求选择或结合使用,助力开发者实现强大的NLP功能。
- 深度Q网络(DQN)结合深度学习与Q学习,在Atari游戏等领域取得显著成绩,但在非马尔可夫环境中面临挑战。传统DQN基于马尔可夫决策过程(MDP),假设未来状态仅依赖当前状态和动作,忽视历史信息,导致在复杂环境中表现不佳。为此,研究人员提出了三种改进策略:1) 记忆增强型DQN,引入LSTM等记忆模块;2) 基于模型的强化学习结合,通过预测环境动态提升决策准确性; 深度Q网络(DQN)结合深度学习与Q学习,在Atari游戏等领域取得显著成绩,但在非马尔可夫环境中面临挑战。传统DQN基于马尔可夫决策过程(MDP),假设未来状态仅依赖当前状态和动作,忽视历史信息,导致在复杂环境中表现不佳。为此,研究人员提出了三种改进策略:1) 记忆增强型DQN,引入LSTM等记忆模块;2) 基于模型的强化学习结合,通过预测环境动态提升决策准确性;
- 深度Q网络(DQN)结合深度学习与Q学习,在复杂决策问题如Atari游戏上超越人类水平。然而,传统DQN在处理复杂环境时存在局限,难以聚焦关键信息。引入注意力机制后,DQN能更好地提取状态特征、优化动作价值评估,并解决时间序列依赖问题。实验表明,改进后的DQN在游戏和机器人操作任务中表现出色,提升了决策效率和准确性。尽管面临计算复杂度等挑战,未来有望通过硬件提升和算法优化进一步推动其应用与发展。 深度Q网络(DQN)结合深度学习与Q学习,在复杂决策问题如Atari游戏上超越人类水平。然而,传统DQN在处理复杂环境时存在局限,难以聚焦关键信息。引入注意力机制后,DQN能更好地提取状态特征、优化动作价值评估,并解决时间序列依赖问题。实验表明,改进后的DQN在游戏和机器人操作任务中表现出色,提升了决策效率和准确性。尽管面临计算复杂度等挑战,未来有望通过硬件提升和算法优化进一步推动其应用与发展。
- 深度Q网络(DQN)结合深度学习与Q学习,通过神经网络逼近Q值函数,指导智能体在不同状态下选择最优动作。其核心优势在于解决高维状态空间下的决策问题,利用经验回放机制和目标网络提高训练稳定性。设计高效DQN需考虑输入层、隐藏层及输出层结构,针对不同任务选择合适的网络架构,如CNN处理图像数据,MLP应对数值型状态。 深度Q网络(DQN)结合深度学习与Q学习,通过神经网络逼近Q值函数,指导智能体在不同状态下选择最优动作。其核心优势在于解决高维状态空间下的决策问题,利用经验回放机制和目标网络提高训练稳定性。设计高效DQN需考虑输入层、隐藏层及输出层结构,针对不同任务选择合适的网络架构,如CNN处理图像数据,MLP应对数值型状态。
- 深度Q网络(DQN)在平稳环境中表现出色,但在非平稳环境下面临诸多挑战。例如,自动驾驶和金融市场中的动态变化导致Q值函数失效和数据分布漂移,使DQN难以适应。为此,研究者提出了改进经验回放机制、动态调整学习率和引入多模型融合等策略,以增强DQN的适应性。实际案例表明,这些改进显著提升了DQN在智能交通和工业控制中的表现。未来,进一步优化DQN在非平稳环境下的学习策略仍是关键研究方向。 深度Q网络(DQN)在平稳环境中表现出色,但在非平稳环境下面临诸多挑战。例如,自动驾驶和金融市场中的动态变化导致Q值函数失效和数据分布漂移,使DQN难以适应。为此,研究者提出了改进经验回放机制、动态调整学习率和引入多模型融合等策略,以增强DQN的适应性。实际案例表明,这些改进显著提升了DQN在智能交通和工业控制中的表现。未来,进一步优化DQN在非平稳环境下的学习策略仍是关键研究方向。
- 深度Q网络(DQN)结合了深度学习与强化学习,解决了高维状态空间下Q表的存储和计算难题。然而,在高维连续状态空间中,DQN面临训练不稳定、收敛慢等问题。优化策略包括改进神经网络结构(如使用CNN、RNN或Transformer)、引入注意力机制、采用优先经验回放(PER)及调整目标网络更新策略等。这些方法提高了DQN在自动驾驶、机器人操作等复杂任务中的性能,未来有望在更多领域取得突破。 深度Q网络(DQN)结合了深度学习与强化学习,解决了高维状态空间下Q表的存储和计算难题。然而,在高维连续状态空间中,DQN面临训练不稳定、收敛慢等问题。优化策略包括改进神经网络结构(如使用CNN、RNN或Transformer)、引入注意力机制、采用优先经验回放(PER)及调整目标网络更新策略等。这些方法提高了DQN在自动驾驶、机器人操作等复杂任务中的性能,未来有望在更多领域取得突破。
- 梯度下降法与共轭梯度法是机器学习和优化中的重要算法。梯度下降法每次沿最速下降方向迭代,收敛慢且易出现“之字形”路径;共轭梯度法则利用共轭方向,避免重复搜索,收敛更快,尤其在二次型问题中表现优异。梯度下降法对步长敏感,存储需求大;共轭梯度法存储需求低,适合大规模问题。选择算法需综合考虑问题特性、数据规模及精度要求。 梯度下降法与共轭梯度法是机器学习和优化中的重要算法。梯度下降法每次沿最速下降方向迭代,收敛慢且易出现“之字形”路径;共轭梯度法则利用共轭方向,避免重复搜索,收敛更快,尤其在二次型问题中表现优异。梯度下降法对步长敏感,存储需求大;共轭梯度法存储需求低,适合大规模问题。选择算法需综合考虑问题特性、数据规模及精度要求。
- 梯度下降算法是机器学习中寻找函数最小值的核心方法,而海森矩阵作为二阶偏导数矩阵,在优化过程中扮演着关键角色。它不仅帮助判断函数的凸性,确保全局最优解的收敛,还通过优化搜索方向和动态调整学习率,提高算法的稳定性和收敛速度。深入理解海森矩阵,能显著提升梯度下降算法的性能,助力更高效的模型训练与优化。 梯度下降算法是机器学习中寻找函数最小值的核心方法,而海森矩阵作为二阶偏导数矩阵,在优化过程中扮演着关键角色。它不仅帮助判断函数的凸性,确保全局最优解的收敛,还通过优化搜索方向和动态调整学习率,提高算法的稳定性和收敛速度。深入理解海森矩阵,能显著提升梯度下降算法的性能,助力更高效的模型训练与优化。
- 凸优化和梯度下降是机器学习与数学优化中的核心概念。凸优化旨在最小化凸函数在凸集合上的取值,其特性保证了局部最优即为全局最优,简化了求解过程。梯度下降则通过迭代更新参数,沿负梯度方向逐步减小目标函数值。两者紧密关联:凸函数的良好性质确保梯度下降能可靠收敛至全局最优,且在实际应用中广泛使用,如线性回归和逻辑回归。掌握它们的关系对解决复杂优化问题至关重要。 凸优化和梯度下降是机器学习与数学优化中的核心概念。凸优化旨在最小化凸函数在凸集合上的取值,其特性保证了局部最优即为全局最优,简化了求解过程。梯度下降则通过迭代更新参数,沿负梯度方向逐步减小目标函数值。两者紧密关联:凸函数的良好性质确保梯度下降能可靠收敛至全局最优,且在实际应用中广泛使用,如线性回归和逻辑回归。掌握它们的关系对解决复杂优化问题至关重要。
- Downpour SGD是随机梯度下降(SGD)的一种变体,采用参数服务器架构,通过数据并行机制将大规模数据集分割到多个工作节点进行并行计算。它使用异步梯度更新策略,减少通信开销,提高训练效率,并结合自适应学习率调整机制,确保模型稳定收敛。该算法在图像识别、语音识别、自然语言处理和推荐系统等领域表现出色,显著加速模型训练,提升性能和准确性。 Downpour SGD是随机梯度下降(SGD)的一种变体,采用参数服务器架构,通过数据并行机制将大规模数据集分割到多个工作节点进行并行计算。它使用异步梯度更新策略,减少通信开销,提高训练效率,并结合自适应学习率调整机制,确保模型稳定收敛。该算法在图像识别、语音识别、自然语言处理和推荐系统等领域表现出色,显著加速模型训练,提升性能和准确性。
- Hogwild!算法是一种实现无锁并行随机梯度下降(SGD)的创新方法,广泛应用于深度学习和大规模数据处理。它通过数据并行架构、无锁更新策略和异步更新机制,允许多个计算节点同时更新共享模型参数,无需等待或同步。这不仅减少了通信开销,提高了资源利用率,还简化了实现和扩展。Hogwild!在图像识别、语音识别等任务中显著加速了模型训练,推动了人工智能技术的发展。 Hogwild!算法是一种实现无锁并行随机梯度下降(SGD)的创新方法,广泛应用于深度学习和大规模数据处理。它通过数据并行架构、无锁更新策略和异步更新机制,允许多个计算节点同时更新共享模型参数,无需等待或同步。这不仅减少了通信开销,提高了资源利用率,还简化了实现和扩展。Hogwild!在图像识别、语音识别等任务中显著加速了模型训练,推动了人工智能技术的发展。
- 本方案基于Flexus应用服务器L实例通过Ollama部署DeepSeek-R1:1.5B 蒸馏版轻量模型,帮助您快速打造私人AI助手。DeepSeek-R1是一个高性能的AI推理模型,专注于数学、代码和自然语言推理任务。 本方案基于Flexus应用服务器L实例通过Ollama部署DeepSeek-R1:1.5B 蒸馏版轻量模型,帮助您快速打造私人AI助手。DeepSeek-R1是一个高性能的AI推理模型,专注于数学、代码和自然语言推理任务。
- Adagrad算法通过自适应调整学习率,根据参数梯度的累积平方动态改变每个参数的学习率。初始时设置学习率η,每次迭代计算梯度并累积其平方,更新后的学习率为η/√(r_t+ε),使频繁更新的参数学习率减小,稀疏参数学习率增大。适用于稀疏数据、特征重要性差异大、前期快速探索及简单模型场景。然而,学习率单调递减可能影响后期训练效果。 Adagrad算法通过自适应调整学习率,根据参数梯度的累积平方动态改变每个参数的学习率。初始时设置学习率η,每次迭代计算梯度并累积其平方,更新后的学习率为η/√(r_t+ε),使频繁更新的参数学习率减小,稀疏参数学习率增大。适用于稀疏数据、特征重要性差异大、前期快速探索及简单模型场景。然而,学习率单调递减可能影响后期训练效果。
上滑加载中
推荐直播
-
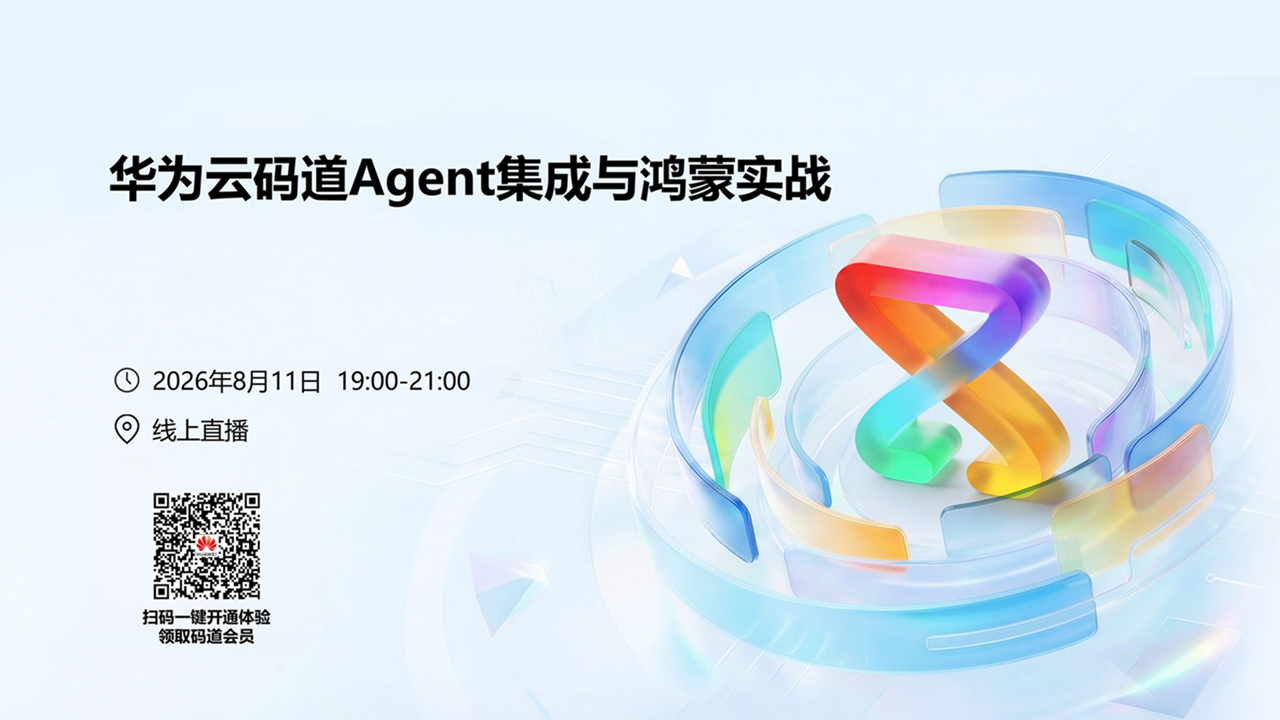 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
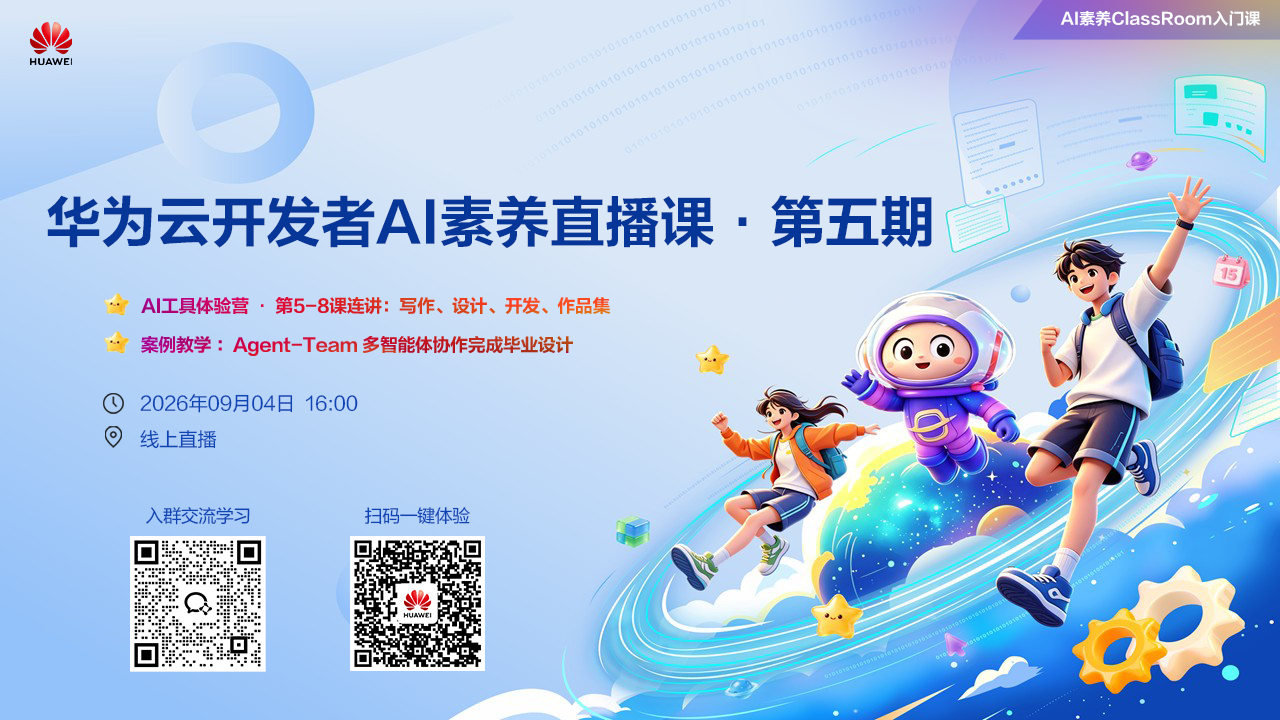 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签