- 本节书摘来自华章计算机《MXNet深度学习实战》一书中的第1章,第1.2.2节,作者是魏凯峰。 本节书摘来自华章计算机《MXNet深度学习实战》一书中的第1章,第1.2.2节,作者是魏凯峰。
- torch.mean函数原型:torch.mean(data,dim=None, keepdim=False)作用:计算指定维度的平均值参数:data:输入的数据dim:指定的维度,如果为None则表示对所有维度进行keepdim:是否保留计算平均值的维度,保留后该维度的长度为1示例:import torchdata = torch.randn(2,3,4)print("原始数据")pri... torch.mean函数原型:torch.mean(data,dim=None, keepdim=False)作用:计算指定维度的平均值参数:data:输入的数据dim:指定的维度,如果为None则表示对所有维度进行keepdim:是否保留计算平均值的维度,保留后该维度的长度为1示例:import torchdata = torch.randn(2,3,4)print("原始数据")pri...
- 第一次把微调任务从单卡迁到4卡DDP,踩了一串坑。从"能跑"到"线性加速"中间隔着三步,记录完整过程。第一步,跑通。DDP的基本结构:torchrun启动多进程,每个进程持有一份模型副本,DistributedSampler保证各卡数据不重叠,反向传播时梯度自动all-reduce同步。最常见的报错是没设rank判断就所有进程都写checkpoint和打日志,磁盘和日志直接打架,所有IO操作... 第一次把微调任务从单卡迁到4卡DDP,踩了一串坑。从"能跑"到"线性加速"中间隔着三步,记录完整过程。第一步,跑通。DDP的基本结构:torchrun启动多进程,每个进程持有一份模型副本,DistributedSampler保证各卡数据不重叠,反向传播时梯度自动all-reduce同步。最常见的报错是没设rank判断就所有进程都写checkpoint和打日志,磁盘和日志直接打架,所有IO操作...
- 在 PyTorch 里跑模型训练时,前向传播只管照着公式往前算,等到调一句 loss.backward(),所有参数的梯度就自动算好了。这套自动求导机制之所以知道该沿着什么路径往回传梯度,全靠张量身上的两个核心属性在背后记账,一个是 requires_grad,另一个是 grad_fn。直接用 torch.tensor() 新建普通张量时,requires_grad 默认是 False,代表... 在 PyTorch 里跑模型训练时,前向传播只管照着公式往前算,等到调一句 loss.backward(),所有参数的梯度就自动算好了。这套自动求导机制之所以知道该沿着什么路径往回传梯度,全靠张量身上的两个核心属性在背后记账,一个是 requires_grad,另一个是 grad_fn。直接用 torch.tensor() 新建普通张量时,requires_grad 默认是 False,代表...
- PyTorch 是动态图深度学习框架,学术界主流。涵盖 Tensor 操作、自动微分(autograd)、神经网络模块(nn.Module)、损失函数与优化器、数据加载(Dataset/DataLoader)、GPU 加速、模型保存加载,以及 Hugging Face 生态。 文章从技术背景和发展历程入手,帮助读者理解该技术的产生原因和演进脉络。通过对比不同版本的特性变化,分析技术选型的考量... PyTorch 是动态图深度学习框架,学术界主流。涵盖 Tensor 操作、自动微分(autograd)、神经网络模块(nn.Module)、损失函数与优化器、数据加载(Dataset/DataLoader)、GPU 加速、模型保存加载,以及 Hugging Face 生态。 文章从技术背景和发展历程入手,帮助读者理解该技术的产生原因和演进脉络。通过对比不同版本的特性变化,分析技术选型的考量...
- PyTorch 框架深度解析(五):分布式计算与并行基础设施在本系列的前四篇文章中,我们自顶向下地梳理了 PyTorch 的前端 API、动态反向微分系统、C++ 算子调度底层,以及突破单节点性能极限的现代编译技术栈。然而,在如今“缩放定律(Scaling Laws)”驱动的大模型(LLM)时代,千亿甚至万亿参数规模的模型早已远远超出了单一硬件设备的显存与算力极限。单机的极致性能只是基础,... PyTorch 框架深度解析(五):分布式计算与并行基础设施在本系列的前四篇文章中,我们自顶向下地梳理了 PyTorch 的前端 API、动态反向微分系统、C++ 算子调度底层,以及突破单节点性能极限的现代编译技术栈。然而,在如今“缩放定律(Scaling Laws)”驱动的大模型(LLM)时代,千亿甚至万亿参数规模的模型早已远远超出了单一硬件设备的显存与算力极限。单机的极致性能只是基础,...
- PyTorch 框架深度解析(四):现代编译栈与图优化子系统在上一篇文章中,我们探讨了 PyTorch 底层通过 ATen 和 Dispatcher 实现的高效 C++ 调度系统。然而,无论底层的算子执行多么迅捷,PyTorch 作为“动态图(Eager Mode)”框架的固有缺陷始终存在:Python 解释器的逐行执行机制带来了巨大的框架开销(Framework Overhead),且缺... PyTorch 框架深度解析(四):现代编译栈与图优化子系统在上一篇文章中,我们探讨了 PyTorch 底层通过 ATen 和 Dispatcher 实现的高效 C++ 调度系统。然而,无论底层的算子执行多么迅捷,PyTorch 作为“动态图(Eager Mode)”框架的固有缺陷始终存在:Python 解释器的逐行执行机制带来了巨大的框架开销(Framework Overhead),且缺...
- PyTorch 框架深度解析(三):C++算子底层与高效调度中心在前两篇文章中,我们探讨了 PyTorch 在 Python 侧的优雅抽象以及基于动态图的 Autograd 机制。然而,Python 作为一种解释型语言,其固有的全局解释器锁(GIL)和动态类型检查开销,使得它注定无法承担密集的张量数学运算。PyTorch 之所以能够在大规模矩阵乘法和深度学习训练中展现出比肩 C/C++ 原... PyTorch 框架深度解析(三):C++算子底层与高效调度中心在前两篇文章中,我们探讨了 PyTorch 在 Python 侧的优雅抽象以及基于动态图的 Autograd 机制。然而,Python 作为一种解释型语言,其固有的全局解释器锁(GIL)和动态类型检查开销,使得它注定无法承担密集的张量数学运算。PyTorch 之所以能够在大规模矩阵乘法和深度学习训练中展现出比肩 C/C++ 原...
- PyTorch 框架深度解析(二):核心执行引擎与动态微分系统在上一篇文章中,我们探讨了 PyTorch 优雅的前端建模 API。然而,深度学习框架的真正技术壁垒在于如何高效、准确地计算动辄数亿参数的数学梯度。在早期框架(如 TensorFlow 1.x 和 Theano)普遍采用静态图(Define-and-Run)的时代,PyTorch 凭借“动态图(Define-by-Run)”机制... PyTorch 框架深度解析(二):核心执行引擎与动态微分系统在上一篇文章中,我们探讨了 PyTorch 优雅的前端建模 API。然而,深度学习框架的真正技术壁垒在于如何高效、准确地计算动辄数亿参数的数学梯度。在早期框架(如 TensorFlow 1.x 和 Theano)普遍采用静态图(Define-and-Run)的时代,PyTorch 凭借“动态图(Define-by-Run)”机制...
- PyTorch 框架深度解析(一):用户接口与高级建模层在当今的深度学习生态中,PyTorch 凭借其“动态图优先(Eager-first)”的设计理念和高度 Pythonic 的编程接口,成为了学术界与工业界的主流框架。然而,对于底层的工程实现而言,优雅的前端 API 必须能够无缝桥接极其复杂的底层 C++ 执行引擎和异构硬件调度系统。本文作为 PyTorch 架构深度解析系列的首篇文章... PyTorch 框架深度解析(一):用户接口与高级建模层在当今的深度学习生态中,PyTorch 凭借其“动态图优先(Eager-first)”的设计理念和高度 Pythonic 的编程接口,成为了学术界与工业界的主流框架。然而,对于底层的工程实现而言,优雅的前端 API 必须能够无缝桥接极其复杂的底层 C++ 执行引擎和异构硬件调度系统。本文作为 PyTorch 架构深度解析系列的首篇文章...
- 昇腾生态里,应用开发者最常见的任务不是重写模型,而是把已有的 PyTorch 代码迁移到 NPU 上跑起来,并且跑得够快。好消息是,torch_npu 作为 PyTorch 的昇腾适配插件,让这件事的代码改动量通常只有几十行。坏消息是,"能跑"和"跑得好"之间,还隔着精度对齐、混合精度、多卡通信、算子回退、性能瓶颈排查一整套工程问题。本文按"先正确、后性能"的顺序,把这条路径完整走一遍。 一... 昇腾生态里,应用开发者最常见的任务不是重写模型,而是把已有的 PyTorch 代码迁移到 NPU 上跑起来,并且跑得够快。好消息是,torch_npu 作为 PyTorch 的昇腾适配插件,让这件事的代码改动量通常只有几十行。坏消息是,"能跑"和"跑得好"之间,还隔着精度对齐、混合精度、多卡通信、算子回退、性能瓶颈排查一整套工程问题。本文按"先正确、后性能"的顺序,把这条路径完整走一遍。 一...
- PyTorch 是动态图深度学习框架,学术界主流。涵盖 Tensor 操作、自动微分(autograd)、神经网络模块(nn.Module)、损失函数与优化器、数据加载(Dataset/DataLoader)、GPU 加速、模型保存加载,以及 Hugging Face 生态。 文章从技术背景和发展历程入手,帮助读者理解该技术的产生原因和演进脉络。通过对比不同版本的特性变化,分析技术选型的考量... PyTorch 是动态图深度学习框架,学术界主流。涵盖 Tensor 操作、自动微分(autograd)、神经网络模块(nn.Module)、损失函数与优化器、数据加载(Dataset/DataLoader)、GPU 加速、模型保存加载,以及 Hugging Face 生态。 文章从技术背景和发展历程入手,帮助读者理解该技术的产生原因和演进脉络。通过对比不同版本的特性变化,分析技术选型的考量...
- 10 月 20 日,在 PyTorch Conference 2026 上,Google 与 Meta 的 PyTorch 团队联合开源了 TorchTPU:一个为 Google TPU 打造的原生 PyTorch 后端。过去想在 TPU 上跑 PyTorch,要么重写成 JAX,要么忍受 PyTorch/XLA 的种种限制。现在,官方给出的迁移方式只有一行:把 model.to("cuda... 10 月 20 日,在 PyTorch Conference 2026 上,Google 与 Meta 的 PyTorch 团队联合开源了 TorchTPU:一个为 Google TPU 打造的原生 PyTorch 后端。过去想在 TPU 上跑 PyTorch,要么重写成 JAX,要么忍受 PyTorch/XLA 的种种限制。现在,官方给出的迁移方式只有一行:把 model.to("cuda...
- PyTorch 是动态图深度学习框架,学术界主流。涵盖 Tensor 操作、自动微分(autograd)、神经网络模块(nn.Module)、损失函数与优化器、数据加载(Dataset/DataLoader)、GPU 加速、模型保存加载,以及 Hugging Face 生态。 PyTorch 是动态图深度学习框架,学术界主流。涵盖 Tensor 操作、自动微分(autograd)、神经网络模块(nn.Module)、损失函数与优化器、数据加载(Dataset/DataLoader)、GPU 加速、模型保存加载,以及 Hugging Face 生态。
- 在深度学习模型训练与推理中,内存带宽往往是比计算峰值更大的瓶颈。本文系统剖析 OpenAI Triton 编译器的算子融合机理,以及如何通过 SRAM 局部性优化消除显存往返开销。 在深度学习模型训练与推理中,内存带宽往往是比计算峰值更大的瓶颈。本文系统剖析 OpenAI Triton 编译器的算子融合机理,以及如何通过 SRAM 局部性优化消除显存往返开销。

上滑加载中
推荐直播
-
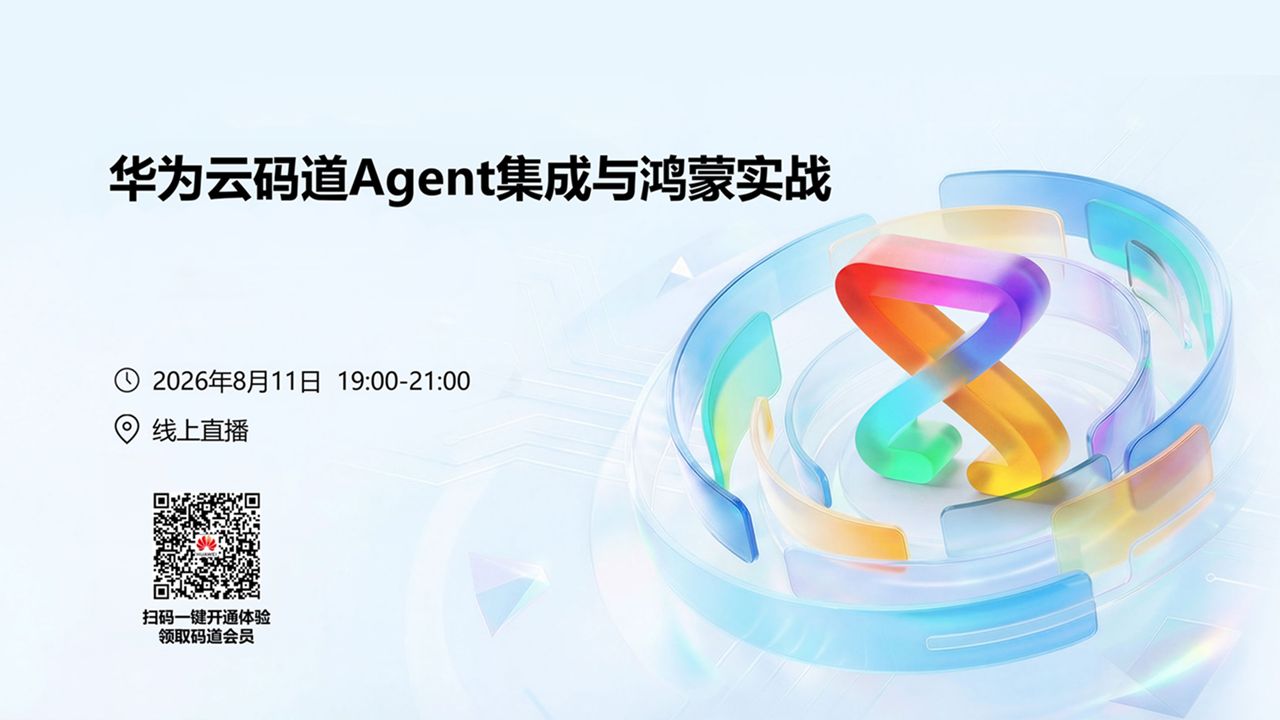 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
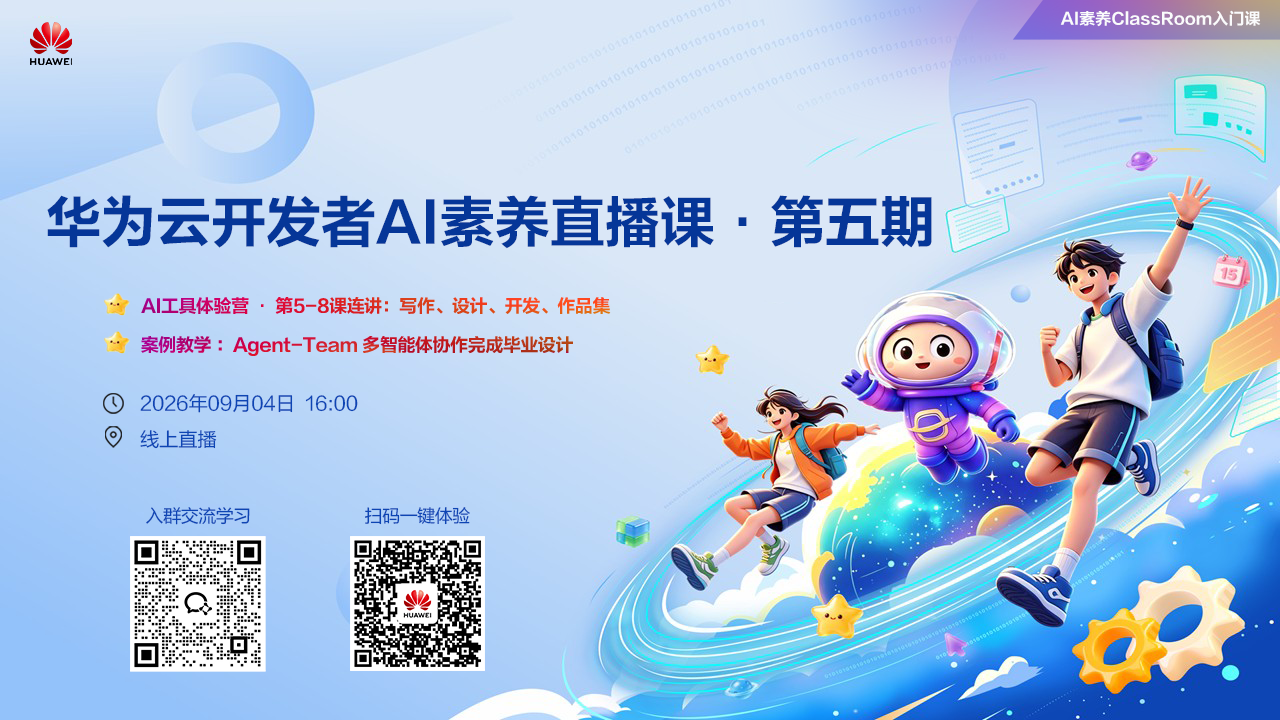 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签