- 一篇搞懂:企业级智能体平台怎么搭,桌面 AI 助手怎么用。 一篇搞懂:企业级智能体平台怎么搭,桌面 AI 助手怎么用。
- 摘要NVIDIA 在 11 月 4 日的技术博客里公开了一个企业助手 Agent 的失败:用户让它起草一封邮件,它起草完直接调用了发送工具。文章给出的判定器只问一件事——有没有在无人确认时调用发送工具。这个看似简单的判定线,背后是三种不同层级的"完成"定义。这篇把三种定义拆开,讲清哪一层该写断言、留出集为什么要对改代码的 Agent 隐藏,以及把故障 trace 变成每日用例的实际成本。需... 摘要NVIDIA 在 11 月 4 日的技术博客里公开了一个企业助手 Agent 的失败:用户让它起草一封邮件,它起草完直接调用了发送工具。文章给出的判定器只问一件事——有没有在无人确认时调用发送工具。这个看似简单的判定线,背后是三种不同层级的"完成"定义。这篇把三种定义拆开,讲清哪一层该写断言、留出集为什么要对改代码的 Agent 隐藏,以及把故障 trace 变成每日用例的实际成本。需...
- 一句话定位:这不是"AI 审得好不好",而是"两个 Agent 互相审,会不会把对方拖死"——被测对象是审查循环能不能收敛,不是某条意见对不对。同样的收敛规则可迁移到自动修复循环、告警去重、多轮评审、机器人客服转人工等任何"自动化会自己叫停自己"的场景。 摘要Anthropic 的 Claude Code 团队在 2026 年 10 月 15 日公开了他们的代码审查流程:六层关卡,按风险分档... 一句话定位:这不是"AI 审得好不好",而是"两个 Agent 互相审,会不会把对方拖死"——被测对象是审查循环能不能收敛,不是某条意见对不对。同样的收敛规则可迁移到自动修复循环、告警去重、多轮评审、机器人客服转人工等任何"自动化会自己叫停自己"的场景。 摘要Anthropic 的 Claude Code 团队在 2026 年 10 月 15 日公开了他们的代码审查流程:六层关卡,按风险分档...
- 本文揭示AI时代质量度量的核心陷阱:指标失真源于口径异化而非数量变化。当Agent驱动开发,提交数、PR量、CI通过率、覆盖率等传统指标纷纷“变味”。文章剖析四大失真场景,提出可落地的替代指标——聚焦“有效变更率”“回滚率”“门禁通过率”“变更隔离度”,强调质量报告的本质是衡量“对产出的理解力”,而非单纯计数。 本文揭示AI时代质量度量的核心陷阱:指标失真源于口径异化而非数量变化。当Agent驱动开发,提交数、PR量、CI通过率、覆盖率等传统指标纷纷“变味”。文章剖析四大失真场景,提出可落地的替代指标——聚焦“有效变更率”“回滚率”“门禁通过率”“变更隔离度”,强调质量报告的本质是衡量“对产出的理解力”,而非单纯计数。
- 本文聚焦训推精度一致性验证:同一权重下,不同并行切分(如TP/DCP)、量化配置或硬件环境是否导致逐token logprob逐位相同。强调不比“容差”,而验“bitwise一致”,为量化上线、混合云部署、多卡扩缩容等场景提供可落地的数值回归方法。 本文聚焦训推精度一致性验证:同一权重下,不同并行切分(如TP/DCP)、量化配置或硬件环境是否导致逐token logprob逐位相同。强调不比“容差”,而验“bitwise一致”,为量化上线、混合云部署、多卡扩缩容等场景提供可落地的数值回归方法。
- 本文剖析Anthropic对AI Agent记忆系统的评测实践,聚焦“错误记忆的存活时长与传播范围”,提出记忆信噪比与四层失效模型(会话记录、笔记、结构化表示、注入上下文),强调测试应覆盖写入质量、检索成本、内容时效与错误传播,并按任务类型分组验收,拒绝以笔记数量或规则合规性替代实效验证。 本文剖析Anthropic对AI Agent记忆系统的评测实践,聚焦“错误记忆的存活时长与传播范围”,提出记忆信噪比与四层失效模型(会话记录、笔记、结构化表示、注入上下文),强调测试应覆盖写入质量、检索成本、内容时效与错误传播,并按任务类型分组验收,拒绝以笔记数量或规则合规性替代实效验证。
- 腾讯混元Hy4是770B参数级开源大模型,首次集成视觉理解、Computer Use与长程Agent能力,在多模态推理、专业软件协同(如Blender/CAD)及跨应用任务规划上实现突破,面向AI架构师与企业级Agent开发者。 腾讯混元Hy4是770B参数级开源大模型,首次集成视觉理解、Computer Use与长程Agent能力,在多模态推理、专业软件协同(如Blender/CAD)及跨应用任务规划上实现突破,面向AI架构师与企业级Agent开发者。
- 摘要腾讯 Hy4 在第三方智能指数拿到 35 分、位居国内实验室第二,同时在 AA-Omniscience 上准确率 50%、幻觉率 89%——也就是说,它不知道答案的时候,89% 的情况会编一个出来而不是说不知道。这两个数字指向同一个问题:能力分和"知道自己不知道"的能力,是两套不同的东西。 本文拆开讲分数该怎么分层读、哪四个维度必须分开记、以及上线前必须补的三项测试。先说两组摆在一起会... 摘要腾讯 Hy4 在第三方智能指数拿到 35 分、位居国内实验室第二,同时在 AA-Omniscience 上准确率 50%、幻觉率 89%——也就是说,它不知道答案的时候,89% 的情况会编一个出来而不是说不知道。这两个数字指向同一个问题:能力分和"知道自己不知道"的能力,是两套不同的东西。 本文拆开讲分数该怎么分层读、哪四个维度必须分开记、以及上线前必须补的三项测试。先说两组摆在一起会...
- 摘要2026 年 11 月 5 日,Cursor 上线"Build Live Apps":云 Agent 可以按一句话需求搭出 Web 应用、开 Postgres 数据库、配好 SSO 登录、部署到一个可分享的链接。发布前会跑确定性与智能体两类安全检查,必须由人显式点击发布才会上线,团队管理员能看到每个应用与密钥、能加审核规则、能下架。这套设计给了测试团队一个清晰的观察点:当 Agent ... 摘要2026 年 11 月 5 日,Cursor 上线"Build Live Apps":云 Agent 可以按一句话需求搭出 Web 应用、开 Postgres 数据库、配好 SSO 登录、部署到一个可分享的链接。发布前会跑确定性与智能体两类安全检查,必须由人显式点击发布才会上线,团队管理员能看到每个应用与密钥、能加审核规则、能下架。这套设计给了测试团队一个清晰的观察点:当 Agent ...
- 摘要: 现在不少测试工程师已经习惯用 AI 辅助编写自动化脚本、生成测试用例,甚至搭建测试框架。但到了技术面试,面对“这段代码是你写的还是 AI 写的”,很多人反而不知道怎么回答。面试官真正关注的,可能不是代码由谁敲出来,而是你能否解释设计思路、发现生成代码的问题,并对最终交付的测试结果负责。本文通过具体的测试开发案例和模拟面试追问,拆解如何回答这个问题。 01. 面试官一句“这是 AI 写... 摘要: 现在不少测试工程师已经习惯用 AI 辅助编写自动化脚本、生成测试用例,甚至搭建测试框架。但到了技术面试,面对“这段代码是你写的还是 AI 写的”,很多人反而不知道怎么回答。面试官真正关注的,可能不是代码由谁敲出来,而是你能否解释设计思路、发现生成代码的问题,并对最终交付的测试结果负责。本文通过具体的测试开发案例和模拟面试追问,拆解如何回答这个问题。 01. 面试官一句“这是 AI 写...
- 摘要自愈测试正在从"换选择器"扩展到"改断言、改用例"。2026年11月1日,开源项目 Qwen Code 的发布说明里给自动修复加了一条很值得抄的规则:最多推3次修复就交回人类。本文拆解自愈的三种"修绿"方式、给出修复权限分级表,并说明怎样用一次受控失败证明你的用例还有验证能力。2026年11月1日,开源项目 Qwen Code 发布 v0.26.5,其中一条变更很不起眼但很关键:无人值... 摘要自愈测试正在从"换选择器"扩展到"改断言、改用例"。2026年11月1日,开源项目 Qwen Code 的发布说明里给自动修复加了一条很值得抄的规则:最多推3次修复就交回人类。本文拆解自愈的三种"修绿"方式、给出修复权限分级表,并说明怎样用一次受控失败证明你的用例还有验证能力。2026年11月1日,开源项目 Qwen Code 发布 v0.26.5,其中一条变更很不起眼但很关键:无人值...
- 一次普通的结账改动评审,新增了一个 pricing.ts,里面是一个 formatMoneyCents()。代码写得干净,带了单元测试,功能也跑通了。问题在于,仓库的 packages/currency/src/format.ts 里早就导出了 formatCurrency(),做的是同一件事,只是多承担了一项职责:它执行的是财务在一次真实的分币事故后签字确认的舍入规则。新函数用了四舍五入,... 一次普通的结账改动评审,新增了一个 pricing.ts,里面是一个 formatMoneyCents()。代码写得干净,带了单元测试,功能也跑通了。问题在于,仓库的 packages/currency/src/format.ts 里早就导出了 formatCurrency(),做的是同一件事,只是多承担了一项职责:它执行的是财务在一次真实的分币事故后签字确认的舍入规则。新函数用了四舍五入,...
- 这是一份专为校招生设计的AI项目实战指南:3周打造可验证的退款查询Agent,涵盖6条可失败验收承诺、20条结构化评测用例、4个Trace观测点及2个典型缺陷修复方案,助你用工程化证据应对面试深度追问。 这是一份专为校招生设计的AI项目实战指南:3周打造可验证的退款查询Agent,涵盖6条可失败验收承诺、20条结构化评测用例、4个Trace观测点及2个典型缺陷修复方案,助你用工程化证据应对面试深度追问。
- 本文剖析Agent测试核心痛点:结果正确≠过程可靠。以Google官方天气Agent“厨师人格”实验为例,揭示均分掩盖的工具调用失效问题;提出将产品承诺转为可失败断言、基于Trace四维度归因、用CLI构建回归闭环等实战方法,助力守住Agent质量底线。 本文剖析Agent测试核心痛点:结果正确≠过程可靠。以Google官方天气Agent“厨师人格”实验为例,揭示均分掩盖的工具调用失效问题;提出将产品承诺转为可失败断言、基于Trace四维度归因、用CLI构建回归闭环等实战方法,助力守住Agent质量底线。
- GitHub Copilot Fusion在Universe 2026正式发布,实现任务驱动的动态模型路由。本文聚焦路由引入的四大不确定性(能力漂移、成本延迟波动、格式不一致、静默降级),提出可观测日志、能力契约、降级验证、成本门禁四大测试抓手,并给出可落地的测试矩阵与实践建议。 GitHub Copilot Fusion在Universe 2026正式发布,实现任务驱动的动态模型路由。本文聚焦路由引入的四大不确定性(能力漂移、成本延迟波动、格式不一致、静默降级),提出可观测日志、能力契约、降级验证、成本门禁四大测试抓手,并给出可落地的测试矩阵与实践建议。
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
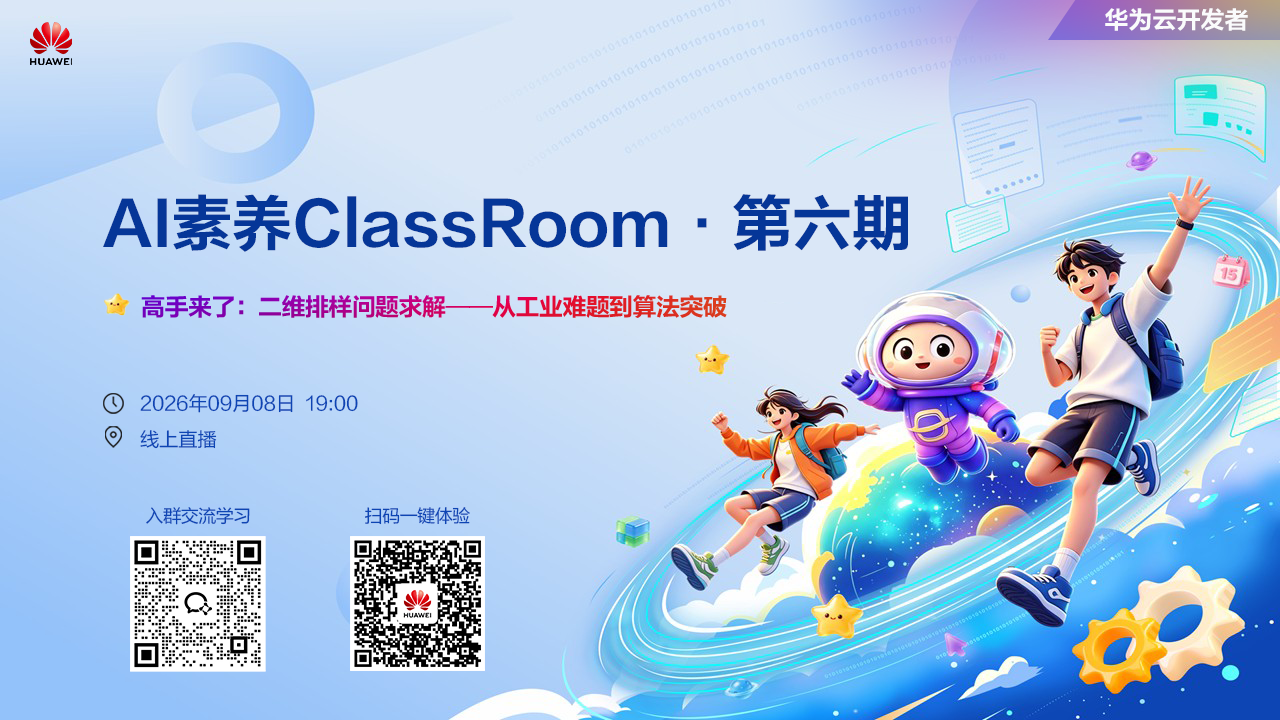 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签