- 上云本应是降本增效,但很多企业上云之后,账单反而越滚越大。实例规格买高了、历史数据堆在SSD上、测试环境没人关、过期快照没清理——每一笔费用都在悄悄累积。本文从云账单的三大“黑洞”出发,拆解云成本失控的根因,给出实例降配、冷热数据分层、僵尸资源清理三条可落地的优化路径,帮助DBA和运维工程师用数据驱动成本优化,让每一分钱都花在刀刃上。 上云本应是降本增效,但很多企业上云之后,账单反而越滚越大。实例规格买高了、历史数据堆在SSD上、测试环境没人关、过期快照没清理——每一笔费用都在悄悄累积。本文从云账单的三大“黑洞”出发,拆解云成本失控的根因,给出实例降配、冷热数据分层、僵尸资源清理三条可落地的优化路径,帮助DBA和运维工程师用数据驱动成本优化,让每一分钱都花在刀刃上。
- 数据库管理工具免费版能扛日常,但遇到数据同步、深度排查、迁移验收就露馅。实测5款付费版核心差异,从开发到运维的实战经验,覆盖开发、迁移、运维全场景,免费版、付费版、原生工具链三维对比,用一张总表理清信创场景选型逻辑。 数据库管理工具免费版能扛日常,但遇到数据同步、深度排查、迁移验收就露馅。实测5款付费版核心差异,从开发到运维的实战经验,覆盖开发、迁移、运维全场景,免费版、付费版、原生工具链三维对比,用一张总表理清信创场景选型逻辑。
- 基于2026年8月已公开的主流模型版本(GPT-5.5、Claude Opus 4.7、Qwen3、Kimi k2.6),实测四个真实业务SQL场景。深入分析基准测试与真实场景的鸿沟、SQL幻觉根因,从准确性、可读性、性能三维度给出量化测评。 基于2026年8月已公开的主流模型版本(GPT-5.5、Claude Opus 4.7、Qwen3、Kimi k2.6),实测四个真实业务SQL场景。深入分析基准测试与真实场景的鸿沟、SQL幻觉根因,从准确性、可读性、性能三维度给出量化测评。
- 慢查询日志20%的价值——剩下的80%是建立性能基线、预测容量瓶颈、评估优化效果、发现潜在风险。本文从慢查询日志的进阶用法出发,讲解如何通过持续记录慢查询建立性能基线、如何通过慢查询趋势预测容量瓶颈、如何将慢查询日志从“故障排查工具”升级为“容量规划工具”,帮助读者从“出了问题再查”升级到“看着趋势主动调整”。 慢查询日志20%的价值——剩下的80%是建立性能基线、预测容量瓶颈、评估优化效果、发现潜在风险。本文从慢查询日志的进阶用法出发,讲解如何通过持续记录慢查询建立性能基线、如何通过慢查询趋势预测容量瓶颈、如何将慢查询日志从“故障排查工具”升级为“容量规划工具”,帮助读者从“出了问题再查”升级到“看着趋势主动调整”。
- 面向多云、异构数据库和持续数据流转的环境,平台能力需要同时覆盖开发接入、治理控制、迁移评估与复制运行。NineData 7 月版本围绕这一链路增加多类型数据源支持,并在安全治理、复制稳定性和 AI 配置体验方面持续完善。扩展 SQL 开发层的异构数据源连接能力从平台能力建设看,本轮调整中,SQL 窗口和 SQL 任务补充 MaxCompute,SQL 窗口新增 AWS Redshift 与 ... 面向多云、异构数据库和持续数据流转的环境,平台能力需要同时覆盖开发接入、治理控制、迁移评估与复制运行。NineData 7 月版本围绕这一链路增加多类型数据源支持,并在安全治理、复制稳定性和 AI 配置体验方面持续完善。扩展 SQL 开发层的异构数据源连接能力从平台能力建设看,本轮调整中,SQL 窗口和 SQL 任务补充 MaxCompute,SQL 窗口新增 AWS Redshift 与 ...
- 2026年国产数据库选型,早已不是“有没有产品可用”的问题,而是不同产品的架构路线、兼容对象和适用负载差异很大。企业一旦选错,不仅会增加应用改造和迁移成本,还可能在上线后遇到性能、容灾和运维问题。本文从业务负载匹配度、迁移成本、信创合规三个维度构建选型决策框架,帮助企业在复杂的国产数据库市场中做出科学决策。 2026年国产数据库选型,早已不是“有没有产品可用”的问题,而是不同产品的架构路线、兼容对象和适用负载差异很大。企业一旦选错,不仅会增加应用改造和迁移成本,还可能在上线后遇到性能、容灾和运维问题。本文从业务负载匹配度、迁移成本、信创合规三个维度构建选型决策框架,帮助企业在复杂的国产数据库市场中做出科学决策。
- 一条SQL慢,可能有一百种原因——SQL写法有问题、索引没建对、统计信息过旧、参数没调好、磁盘I/O满了、内存不够、网络抖动……很多DBA的做法是“先查SQL”,但真正的问题往往不在SQL本身。本文从“分层诊断”的思路出发,建立一套从SQL层→数据库层→操作系统层的逐层排查方法论,帮助读者在面对性能问题时不再“眉毛胡子一把抓”。 一条SQL慢,可能有一百种原因——SQL写法有问题、索引没建对、统计信息过旧、参数没调好、磁盘I/O满了、内存不够、网络抖动……很多DBA的做法是“先查SQL”,但真正的问题往往不在SQL本身。本文从“分层诊断”的思路出发,建立一套从SQL层→数据库层→操作系统层的逐层排查方法论,帮助读者在面对性能问题时不再“眉毛胡子一把抓”。
- UNION和UNION ALL的区别很多人知道,但INTERSECT和EXCEPT的执行机制、性能差异,以及如何用JOIN和子查询替代,很多人并不清楚。本文从集合操作的执行计划出发,拆解UNION去重的“隐形代价”、INTERSECT与INNER JOIN的本质差异、EXCEPT与NOT EXISTS的性能对比,并通过真实案例展示集合操作在业务场景中的正确用法与避坑指南,帮助读者从“会写集合操作” UNION和UNION ALL的区别很多人知道,但INTERSECT和EXCEPT的执行机制、性能差异,以及如何用JOIN和子查询替代,很多人并不清楚。本文从集合操作的执行计划出发,拆解UNION去重的“隐形代价”、INTERSECT与INNER JOIN的本质差异、EXCEPT与NOT EXISTS的性能对比,并通过真实案例展示集合操作在业务场景中的正确用法与避坑指南,帮助读者从“会写集合操作”
- 当业务数据量越过TB级门槛,TaurusDB的写入响应可能不再线性增长——同一段批量插入SQL,执行时间从毫秒级飙升至秒级,CPU利用率却未见明显冲高。这背后通常不是计算节点算力不足,而是存算分离架构下日志提交链路、存储节点合并效率与缓存策略的综合作用。理解这些环节如何拖慢写入,是做好TaurusDB写入性能优化的前提。 当业务数据量越过TB级门槛,TaurusDB的写入响应可能不再线性增长——同一段批量插入SQL,执行时间从毫秒级飙升至秒级,CPU利用率却未见明显冲高。这背后通常不是计算节点算力不足,而是存算分离架构下日志提交链路、存储节点合并效率与缓存策略的综合作用。理解这些环节如何拖慢写入,是做好TaurusDB写入性能优化的前提。
- EXPLAIN能告诉你优化器选了哪个执行计划,但说不出它为什么这么选——明明有索引它却走全表扫描,明明A计划更快它却选了B计划。优化器不靠猜,它靠一套成本模型(Cost Model)做决策。本文从优化器的成本模型出发,拆解cost的构成(IO_cost、CPU_cost、memory_cost),讲解如何通过EXPLAIN FORMAT=JSON和OPTIMIZER_TRACE看到优化器的“思考过 EXPLAIN能告诉你优化器选了哪个执行计划,但说不出它为什么这么选——明明有索引它却走全表扫描,明明A计划更快它却选了B计划。优化器不靠猜,它靠一套成本模型(Cost Model)做决策。本文从优化器的成本模型出发,拆解cost的构成(IO_cost、CPU_cost、memory_cost),讲解如何通过EXPLAIN FORMAT=JSON和OPTIMIZER_TRACE看到优化器的“思考过
- Buffer Pool命中率是MySQL性能监控的核心指标之一,但99%的命中率不代表没有问题。本文从Buffer Pool工作原理出发,解析命中率骗局的成因、真正的诊断方法和调优策略。 Buffer Pool命中率是MySQL性能监控的核心指标之一,但99%的命中率不代表没有问题。本文从Buffer Pool工作原理出发,解析命中率骗局的成因、真正的诊断方法和调优策略。
- 别让你的DBA在凌晨三点接到那通电话大家好,我是某互联网公司数据平台团队的负责人,负责数据治理和ETL体系建设。今天聊一个让我至今心有余悸的事故——我们的AI数据清洗助手,因为"吃"了生产环境的脏数据,反手生成了一段把核心业务表全表清空的SQL脚本。万幸的是,我们在预发布环境拦截了,没有酿成大祸。但复盘的过程让我出了一身冷汗。 一、故事的起点:让AI"自学"数据清洗规则去年年底,我们上线了一... 别让你的DBA在凌晨三点接到那通电话大家好,我是某互联网公司数据平台团队的负责人,负责数据治理和ETL体系建设。今天聊一个让我至今心有余悸的事故——我们的AI数据清洗助手,因为"吃"了生产环境的脏数据,反手生成了一段把核心业务表全表清空的SQL脚本。万幸的是,我们在预发布环境拦截了,没有酿成大祸。但复盘的过程让我出了一身冷汗。 一、故事的起点:让AI"自学"数据清洗规则去年年底,我们上线了一...
- 参数调好了,索引也建了,SQL写法也优化了——但表结构设计阶段的一个字段类型选错,可能导致一切都白费。本文从字段类型选择的性能代价出发,通过VARCHAR vs CHAR、DATETIME vs TIMESTAMP等实测对比,拆解字符集陷阱、NULL值对索引的影响,以及表结构调整的“晚期成本”,帮助读者从源头避免性能问题。 参数调好了,索引也建了,SQL写法也优化了——但表结构设计阶段的一个字段类型选错,可能导致一切都白费。本文从字段类型选择的性能代价出发,通过VARCHAR vs CHAR、DATETIME vs TIMESTAMP等实测对比,拆解字符集陷阱、NULL值对索引的影响,以及表结构调整的“晚期成本”,帮助读者从源头避免性能问题。
- 别让你的DBA在凌晨三点接到那通电话大家好,我是某互联网公司数据平台团队的负责人,负责数据治理和ETL体系建设。今天聊一个让我至今心有余悸的事故——我们的AI数据清洗助手,因为"吃"了生产环境的脏数据,反手生成了一段把核心业务表全表清空的SQL脚本。万幸的是,我们在预发布环境拦截了,没有酿成大祸。但复盘的过程让我出了一身冷汗。一、故事的起点:让AI"自学"数据清洗规则去年年底,我们上线了一个... 别让你的DBA在凌晨三点接到那通电话大家好,我是某互联网公司数据平台团队的负责人,负责数据治理和ETL体系建设。今天聊一个让我至今心有余悸的事故——我们的AI数据清洗助手,因为"吃"了生产环境的脏数据,反手生成了一段把核心业务表全表清空的SQL脚本。万幸的是,我们在预发布环境拦截了,没有酿成大祸。但复盘的过程让我出了一身冷汗。一、故事的起点:让AI"自学"数据清洗规则去年年底,我们上线了一个...
- 在 Lakehouse 架构中,数据通常以开放湖格式(如 Iceberg)存放在对象存储中,并由 Spark、Flink、Trino、Apache Doris 等计算引擎共同管理和访问。这是一套天然的存算分离架构,并且同一份开放数据可以服务于不同的计算场景。但数据开放,并不意味着操作链路已经统一。围绕同一张 Iceberg 表,之前的分工往往是这样的:Iceberg 做表格式,Spark 负... 在 Lakehouse 架构中,数据通常以开放湖格式(如 Iceberg)存放在对象存储中,并由 Spark、Flink、Trino、Apache Doris 等计算引擎共同管理和访问。这是一套天然的存算分离架构,并且同一份开放数据可以服务于不同的计算场景。但数据开放,并不意味着操作链路已经统一。围绕同一张 Iceberg 表,之前的分工往往是这样的:Iceberg 做表格式,Spark 负...
上滑加载中
推荐直播
-
 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
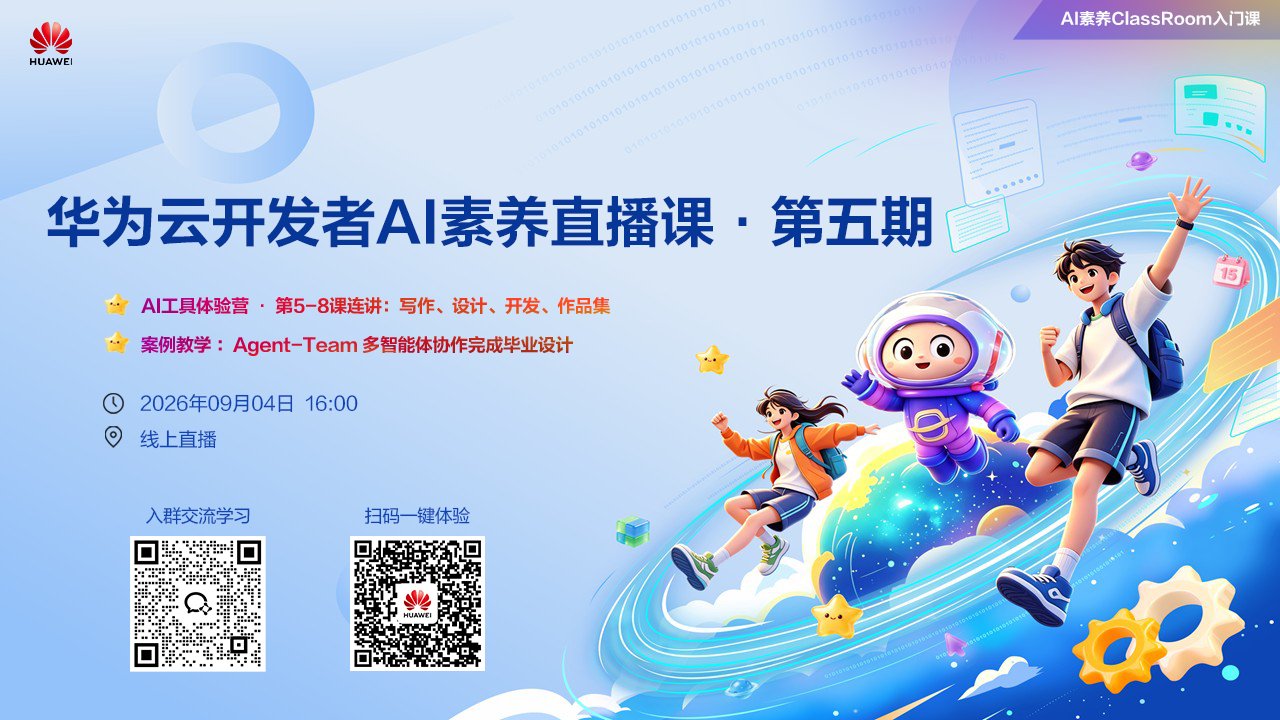 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
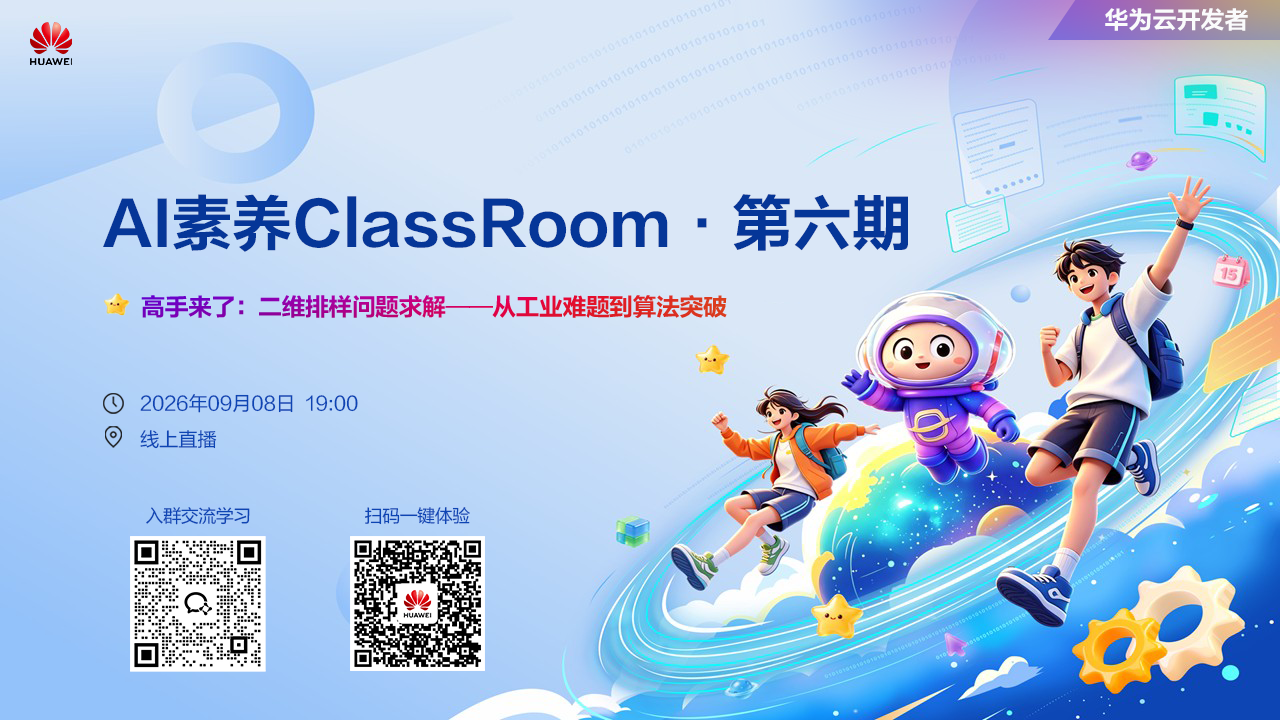 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签