- 华为云开发者成长中心任务自动化实现方案,共16个任务,每日可自动获取570积分。 华为云开发者成长中心任务自动化实现方案,共16个任务,每日可自动获取570积分。
- 面向应届生的多语言SDK契约测试项目:基于OpenAPI生成Python/Java客户端,通过黄金向量验证序列化行为、错误码映射、重试逻辑与SSE流式取消一致性,聚焦“协议合规性”而非仅代码生成,体现深度测开能力。 面向应届生的多语言SDK契约测试项目:基于OpenAPI生成Python/Java客户端,通过黄金向量验证序列化行为、错误码映射、重试逻辑与SSE流式取消一致性,聚焦“协议合规性”而非仅代码生成,体现深度测开能力。
- 有一段Python代码,用来检查购买数量必须在1到99之间。# bad_quantity.py:故意保留问题的教学版本import sysquantity = int(sys.argv[1])assert 1 <= quantity <= 99, "数量超出范围"print(f"接受数量:{quantity}")运行python bad_quantity.py -1,程序报错。看起来,负数已... 有一段Python代码,用来检查购买数量必须在1到99之间。# bad_quantity.py:故意保留问题的教学版本import sysquantity = int(sys.argv[1])assert 1 <= quantity <= 99, "数量超出范围"print(f"接受数量:{quantity}")运行python bad_quantity.py -1,程序报错。看起来,负数已...
- 上个月我把订单中台的回归测试从 Postman 里拽了出来。之前 87 个接口,每次发版前手工点,3 天起步,点到后面人都麻了。现在 CI 上跑 500 多条 pytest,全量回归 3 小时出头,MR 只跑 smoke 的话 20 分钟。核心不是哪个神器,而是把 Swagger 当成数据源,让 AI 补测试场景,再让 pytest 去干重复劳动。下面是我实际落地的过程,代码是删减过的,但骨... 上个月我把订单中台的回归测试从 Postman 里拽了出来。之前 87 个接口,每次发版前手工点,3 天起步,点到后面人都麻了。现在 CI 上跑 500 多条 pytest,全量回归 3 小时出头,MR 只跑 smoke 的话 20 分钟。核心不是哪个神器,而是把 Swagger 当成数据源,让 AI 补测试场景,再让 pytest 去干重复劳动。下面是我实际落地的过程,代码是删减过的,但骨...
- 上个月我把订单中台的回归测试从 Postman 里拽了出来。之前 87 个接口,每次发版前手工点,3 天起步,点到后面人都麻了。现在 CI 上跑 500 多条 pytest,全量回归 3 小时出头,MR 只跑 smoke 的话 20 分钟。核心不是哪个神器,而是把 Swagger 当成数据源,让 AI 补测试场景,再让 pytest 去干重复劳动。下面是我实际落地的过程,代码是删减过的,但骨... 上个月我把订单中台的回归测试从 Postman 里拽了出来。之前 87 个接口,每次发版前手工点,3 天起步,点到后面人都麻了。现在 CI 上跑 500 多条 pytest,全量回归 3 小时出头,MR 只跑 smoke 的话 20 分钟。核心不是哪个神器,而是把 Swagger 当成数据源,让 AI 补测试场景,再让 pytest 去干重复劳动。下面是我实际落地的过程,代码是删减过的,但骨...
- 昨天满月,今天休息。不写代码,随便聊几句。为什么做这个?起因很简单:我的学习资料散在Notion、微信收藏、本地Markdown文件里,想找一道错题翻半天。市面上不是没有题库工具,但要么功能太重,要么不符合我的使用习惯。想着“自己写一个吧”,结果一写就是三十天。最难的是什么?不是技术。RAG、FSRS、微信网关,这些都有现成的方案和文档。最难的是每天挤出时间。工作日晚上两三个小时,周末多一些... 昨天满月,今天休息。不写代码,随便聊几句。为什么做这个?起因很简单:我的学习资料散在Notion、微信收藏、本地Markdown文件里,想找一道错题翻半天。市面上不是没有题库工具,但要么功能太重,要么不符合我的使用习惯。想着“自己写一个吧”,结果一写就是三十天。最难的是什么?不是技术。RAG、FSRS、微信网关,这些都有现成的方案和文档。最难的是每天挤出时间。工作日晚上两三个小时,周末多一些...
- 起点:一个能跑但不够整洁的项目今天看继续改我的[值班排班管理系统],一个基于 Python Flask 的 Web 应用,用来解决固定班底全年值班排班的公平性问题。项目本身不大,核心就两个文件:app.py — Flask 后端,路由 + 内存缓存scheduler.py — 排班算法,真正的"大脑"算法设计其实挺有亮点:用 K₆ 完全图的 1-factorization(5 个完美匹配轮换... 起点:一个能跑但不够整洁的项目今天看继续改我的[值班排班管理系统],一个基于 Python Flask 的 Web 应用,用来解决固定班底全年值班排班的公平性问题。项目本身不大,核心就两个文件:app.py — Flask 后端,路由 + 内存缓存scheduler.py — 排班算法,真正的"大脑"算法设计其实挺有亮点:用 K₆ 完全图的 1-factorization(5 个完美匹配轮换...
- 本文揭示大模型测试中“固定值断言”的致命缺陷:因模型输出天然非确定(字段顺序、类型漂移、冗余文本等),`assert == 固定字典` 导致假红或漏检。提出用属性测试(Hypothesis + Pydantic)替代——聚焦守业务不变量(如金额非负、必填字段存在、不泄露提示),而非形态一致。解耦“输出长什么样”与“输出对不对”,让测试真正守住底线。 本文揭示大模型测试中“固定值断言”的致命缺陷:因模型输出天然非确定(字段顺序、类型漂移、冗余文本等),`assert == 固定字典` 导致假红或漏检。提出用属性测试(Hypothesis + Pydantic)替代——聚焦守业务不变量(如金额非负、必填字段存在、不泄露提示),而非形态一致。解耦“输出长什么样”与“输出对不对”,让测试真正守住底线。
- 本文介绍Agent测试新范式——行为评估(Behavioral Evaluation):摒弃仅校验最终结果的“outcome-only”方式,转而对工具调用轨迹(Trajectory)进行三层断言——工具选择、调用顺序与参数、过程与结果一致性。通过jsonl落库、pytest回归、CI门禁,实现可复现、可归因、防蒙对的高可信测试,让Agent能力而非运气成为上线依据。 本文介绍Agent测试新范式——行为评估(Behavioral Evaluation):摒弃仅校验最终结果的“outcome-only”方式,转而对工具调用轨迹(Trajectory)进行三层断言——工具选择、调用顺序与参数、过程与结果一致性。通过jsonl落库、pytest回归、CI门禁,实现可复现、可归因、防蒙对的高可信测试,让Agent能力而非运气成为上线依据。
- 本文揭示大模型结构化输出的隐性风险:看似合法的JSON,实则存在寒暄前缀、类型漂移、字段缺失/冗余等契约违约问题。裸用`json.loads`无法拦截脏数据,导致静默入库、对账失败。提出将结构化输出视为“接口契约”,通过Pydantic定义严格Schema、正则提取JSON主体、参数化回归测试+线上Golden样本门禁,实现格式校验前置化、自动化、可追溯——让每一次Prompt或模型变更都经得起契 本文揭示大模型结构化输出的隐性风险:看似合法的JSON,实则存在寒暄前缀、类型漂移、字段缺失/冗余等契约违约问题。裸用`json.loads`无法拦截脏数据,导致静默入库、对账失败。提出将结构化输出视为“接口契约”,通过Pydantic定义严格Schema、正则提取JSON主体、参数化回归测试+线上Golden样本门禁,实现格式校验前置化、自动化、可追溯——让每一次Prompt或模型变更都经得起契
- 本文揭示灰度上线中“单开关正常、组合却出错”的典型陷阱,指出全开/全关测试存在巨大盲区。提出以pairwise组合测试为核心解法:用allpairspy自动生成覆盖任意两开关所有搭配的精简用例(如12个开关仅需数十条),结合pytest参数化执行关键链路,并对风控等高危开关对强制全覆盖。兼顾可落地性与缺陷拦截率,让组合测试真正融入CI。 本文揭示灰度上线中“单开关正常、组合却出错”的典型陷阱,指出全开/全关测试存在巨大盲区。提出以pairwise组合测试为核心解法:用allpairspy自动生成覆盖任意两开关所有搭配的精简用例(如12个开关仅需数十条),结合pytest参数化执行关键链路,并对风控等高危开关对强制全覆盖。兼顾可落地性与缺陷拦截率,让组合测试真正融入CI。
- 本文以通义千问Qwen量化GGUF模型为案例,基于Llama.cpp框架展示本地大模型调用与功能开发的完整实现原理及流程。全文采用原生Python编写代码案例,无需依赖重型AI框架,依次实现模型元数据解析、本地接口单次对话调用、多轮对话持久化记忆、自定义工具调用拓展等功能实现逻辑,针对直接调用大模型上下文断裂、功能单一、拓展性不足等问题,通过轻量化对话记忆与工具解析执行框架完成优化实现,拆解... 本文以通义千问Qwen量化GGUF模型为案例,基于Llama.cpp框架展示本地大模型调用与功能开发的完整实现原理及流程。全文采用原生Python编写代码案例,无需依赖重型AI框架,依次实现模型元数据解析、本地接口单次对话调用、多轮对话持久化记忆、自定义工具调用拓展等功能实现逻辑,针对直接调用大模型上下文断裂、功能单一、拓展性不足等问题,通过轻量化对话记忆与工具解析执行框架完成优化实现,拆解...
- 用pandas几行代码把分散在多个csv的销售数据纵向拼接、按部门汇总,一键导出成 Excel 报表。 用pandas几行代码把分散在多个csv的销售数据纵向拼接、按部门汇总,一键导出成 Excel 报表。
- 标签:Python、WebSocket、股票API、金融数据、数据采集 摘要在金融业务开发、量化研究场景中,经常需要同时获取A股、港股、美股多市场实时盘口数据。多终端人工查看的模式不仅效率低下,还会引入观测时差,不利于业务系统、策略模型消费实时数据流。本文从工程落地角度,分享多市场行情API的选型评估思路,同时提供可调试的Python WebSocket示例代码,实现单条长连接订阅三大市场行... 标签:Python、WebSocket、股票API、金融数据、数据采集 摘要在金融业务开发、量化研究场景中,经常需要同时获取A股、港股、美股多市场实时盘口数据。多终端人工查看的模式不仅效率低下,还会引入观测时差,不利于业务系统、策略模型消费实时数据流。本文从工程落地角度,分享多市场行情API的选型评估思路,同时提供可调试的Python WebSocket示例代码,实现单条长连接订阅三大市场行...
- 回归测试有一句被讲了很多年的老话:覆盖要全,用例越多越保险。这句话在手工写用例的年代基本成立——因为每一条用例都很贵,贵到人不会去写第二条几乎一样的。约束本身就在替你做剪枝。AI 把这个约束拆了。现在一句「帮我把这个函数的边界都覆盖上」,几十上百条用例几秒就生成出来,回归集从两三百条涨到上千条只用了两周。于是老话突然失灵了:用例是多了,可跑一轮要四十分钟,真出缺陷时它照样漏。这篇只讲一件事:... 回归测试有一句被讲了很多年的老话:覆盖要全,用例越多越保险。这句话在手工写用例的年代基本成立——因为每一条用例都很贵,贵到人不会去写第二条几乎一样的。约束本身就在替你做剪枝。AI 把这个约束拆了。现在一句「帮我把这个函数的边界都覆盖上」,几十上百条用例几秒就生成出来,回归集从两三百条涨到上千条只用了两周。于是老话突然失灵了:用例是多了,可跑一轮要四十分钟,真出缺陷时它照样漏。这篇只讲一件事:...

上滑加载中
推荐直播
-
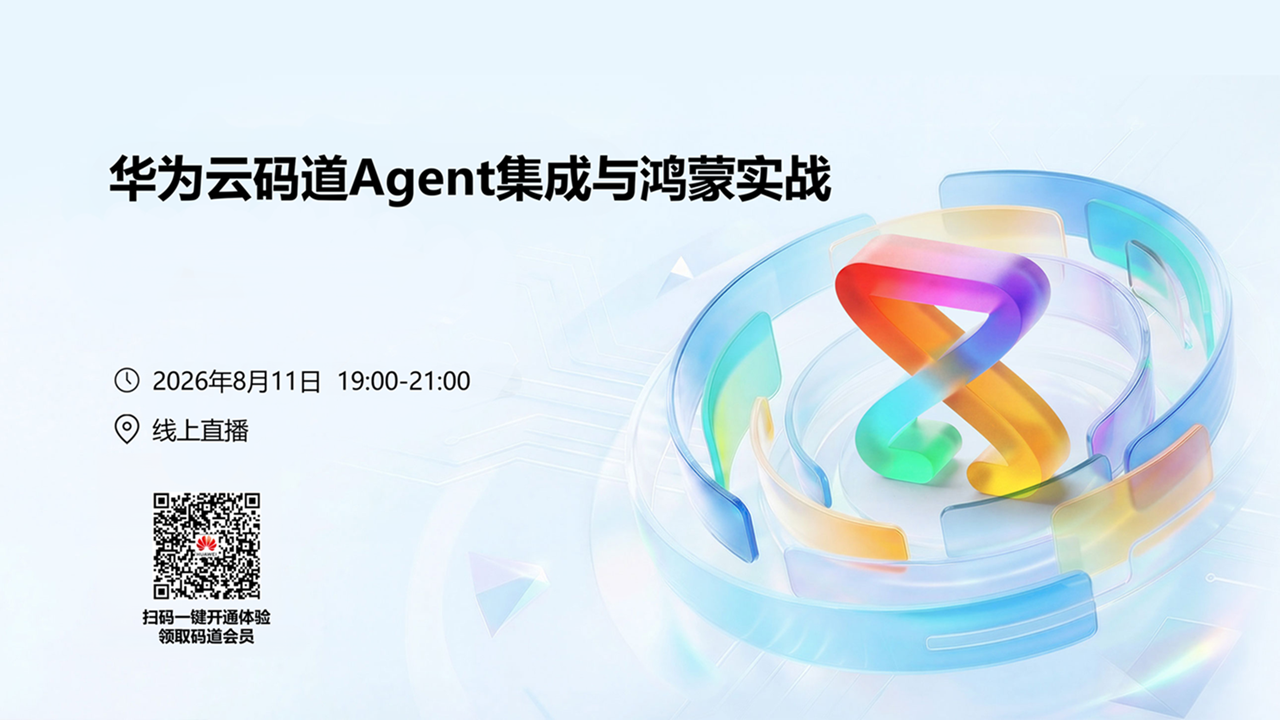 华为云码道Agent集成与鸿蒙实战
2026/08/11 周二 19:00-21:00
王一男-华为云码道产品规划专家;李炎-华为云码道产品专家;彭江敏-华为云鸿蒙端云一体化开发专家
本次直播带你解读华为云码道7月份产品新特性、新功能。更有专家演示码道Agent Space × 钉钉机器集成实战,从0到1打通消息通道;码道鸿蒙端云一体化实战,快速搭建员工签到系统。
回顾中 -
 华为云开发者AI素养直播课·第五期
2026/09/04 周五 16:00-18:00
林华鼎-华为云AI开发者运营负责人;蒋春阳-华为云AI开发者案例开发专家
本期直播内容: AI工具体验营 · 第5-8课连讲。Agent-Team 多智能体协作完成毕业设计实践
回顾中 -
 华为云开发者AI素养ClassRoom·第六期
2026/09/08 周二 19:00-20:00
樊渊-2026华为软件挑战赛冠军
高手来了:看软挑高手解析二维排样问题—从工业难题到算法突破
回顾中
热门标签